„Informace jsou kyslíkem moderního světa,“ řekl Ronald Reagan. Informace skutečně mají velkou hodnotu, ale jejich objem je v současnosti tak velký, že je pro člověka poměrně obtížné je ručně shromažďovat a zpracovávat. Tato okolnost sloužila jako předpoklad pro vznik takového jevu v digitálním prostředí, jako je scraping (parsování) internetových zdrojů.
Navzdory širokému používání tohoto mechanismu 1 zůstává otázka jeho legality poměrně aktuální vzhledem k nedostatku legislativní regulace. P.O. Semin píše, že „na průsečíku scrapingu a práva vznikají problémy týkající se duševního vlastnictví a osobních údajů, smluvního práva a specifik jeho implementace na internetu, trestných činů v oblasti počítačových informací, povinností způsobit škodu na počítačovém zařízení jako majetku.“ Proto se v této práci pokusíme formulovat kritéria pro legalitu scrapingu na základě analýzy zahraniční i domácí praxe.
V první řadě je nutné pochopit, co je scraping. Scraping je „automatizovaný sběr informací z různých internetových zdrojů, který se provádí pomocí speciálně vyvinutého počítačového programu – bota“. Tento program nepoužívá softwarové rozhraní webu, ale napodobuje lidské chování. Funguje následovně: nejprve se web analyzuje – stránky se dočasně načtou do paměti zařízení uživatele v plném rozsahu, aby se z nich následně extrahovaly potřebné informace. Poté probíhá samotné procházení stránek, během kterého se extrahují potřebná data, a poslední fází je organizace shromážděných dat.
- Jaké právní problémy zde mohou vzniknout?
- Co je to webový scraping?
- Jak se používá webový scraping?
- Co je etický webový scraping?
- Jaké typy webových scraperů existují?
- 1. Ruční škrabky
- 2. Jednoduché škrabky
- 3. Vylepšené škrabky
- 4. Prohlížeče bez rozhraní
- 5. API scrapery
- 6. Distribuované škrabky
- Jak fungují webové scrapery?
- Mám při scrapingu webových stránek používat proxy?
- Závěrečné myšlenky: Co je webový scraping v roce 2025?
- Zanechat komentář Zrušit odpověď
- Kontaktujte nás
- Přihlásit se
- O mně
- na webu
- Jak je znázorněno na
Jaké právní problémy zde mohou vzniknout?
1. Scraping a práva duševního vlastnictví
Jak již bylo zmíněno, tento program extrahuje určitá data z webu a kopíruje je do zařízení uživatele 2. Samotný web i informace na něm však mohou být předmětem autorského práva a práv s ním souvisejících, takže jejich volné užívání může být omezeno nebo dokonce zakázáno. V tomto ohledu je nutné pochopit, v jakých případech scraping porušuje práva duševního vlastnictví.
V souladu s odstavcem 2 článku 1260 Občanského zákoníku Ruské federace (dále jen „občanský zákoník“) vlastní autorská práva k výběru nebo uspořádání materiálů autor webových stránek 3 . Dříve však bylo uvedeno, že v důsledku scrapingu jsou z webových stránek extrahovány informace potřebné uživatelem, které jsou následně určitým způsobem uspořádány. Jinými slovy, materiály jsou vybrány a uspořádány v jiném pořadí než na zdrojovém webu. Z toho lze usoudit, že scraping neporušuje autorská práva autora webových stránek.
Stránka může zároveň obsahovat materiály, které jsou předmětem autorských práv: fotografie, video a audio nahrávky, literární díla atd. Bude jejich extrakce porušením? Odpověď na tuto otázku závisí na tom, jak konkrétní program funguje. Uložení veškerého obsahu stránky do zařízení uživatele tedy nebude považováno za reprodukci děl na něm zveřejněných, pokud jsou splněny dvě podmínky. Takové uložení musí být dočasné – za účelem následné extrakce potřebných informací (čl. 1 odst. 2 pododstavec 1270 občanského zákoníku), extrahované informace musí být nechráněné (například ceny produktů). Program však lze nakonfigurovat tak, aby ukládal všechna data do paměti zařízení i po extrakci potřebných materiálů. V tomto případě nelze scraping považovat za legální.
Konečně, internetové stránky mohou být předmětem souvisejících práv, konkrétně databáze. Ne každá databáze však podléhá výlučným právům: její vytvoření vyžaduje značné finanční, materiální, organizační nebo jiné náklady, které se předpokládají u vlastníků stránek obsahujících alespoň 10 tisíc dokumentů. Je důležité poznamenat, že tyto náklady musí být vynaloženy přímo na vytvoření databází a podle doktríny spin-off 4 (vedlejší produkt) nejsou ochraně předmětem ty databáze, které byly vytvořeny společností v rámci její hlavní činnosti a nevyžadovaly samostatné investice do vyhledávání, shromažďování a kontroly těchto údajů.
Kromě toho ne každá extrakce materiálů z webu je porušením, ale pouze přenos celého obsahu databáze nebo významné části materiálů, které ji tvoří (odstavec 2 bodu 1 článku 1334 občanského zákoníku). Současně je podle článku 3 bodu 1335.1 občanského zákoníku zakázáno i opakované získávání nebo použití materiálů, které tvoří nevýznamnou část databáze, pokud takové jednání odporuje běžnému užívání databáze a nepřiměřeně porušuje oprávněné zájmy výrobce databáze.
Abychom tedy pochopili, zda scraping webu porušuje právo na databázi, můžeme použít následující diagram:

Je třeba poznamenat, že vyhledávače, které se obvykle označují jako crawlingové, fungují podobně jako scrapingoví roboti. Zároveň jsou vyhledávače nedílnou součástí internetu a není pochyb o tom, že jejich činnost je legální. Proto se nabízí otázka: proč není scraping (crawling) vyhledávači porušením, zatímco stejné akce prováděné jinými programy jsou soudy často uznávány za nezákonné?
To je pravděpodobně způsobeno tím, že vyhledávač neextrahuje materiály, jak to obvykle dělají jiné programy, ale pouze poskytuje odkazy na potřebné informace. A.S. Vorozhevič tak píše, že v případě, kdy „program žalovaného, podobně jako vyhledávač, umožňuje klientovi získat odkazy na konkrétní uživatelské profily na internetu“, nedochází k porušení. Lze tedy dojít k závěru, že poskytování odkazů na zdrojové stránky programem v důsledku scrapingu bez přímého přenosu příslušných materiálů na jiné zařízení nelze považovat za porušení výhradních práv.
Pokud se vrátíme k otázce zákonnosti použití databáze, poznamenáváme, že článek 1335.1 občanského zákoníku obsahuje podmínky, za kterých je použití databází bez svolení držitele autorských práv zákonné 5 . Je však důležité zdůraznit, že i za těchto podmínek může být scraping považován za nezákonný. O jakých případech mluvíme?
Faktem je, že vlastník webu má právo instalovat technické prostředky ochrany webů, jejichž obcházení je nepřijatelné, i když má daná osoba právo extrahovat materiály z databáze a následně je používat v souladu s výše uvedeným článkem. Vlastník webu má tedy právo zakázat přístup na web z určité IP adresy. Běžným prostředkem ochrany je také soubor robots.txt, určený k rozpoznání programy shromažďujícími informace, a obsahující zákaz nebo povolení k provádění takových akcí. Jeho zvláštností je, že za nedodržování těchto pravidel neexistuje právní odpovědnost; jsou dodržována dobrovolně.
Vyvstává otázka: jaký má smysl používat tento ochranný prostředek pro majitele webů, pokud se nevynucuje dodržování pravidel? Je důležité si uvědomit, že tento soubor je jedním z nejdůležitějších při optimalizaci jakéhokoli webu. Program, který provádí scraping, lze nakonfigurovat tak, aby splňoval pravidla a omezení uvedená v souboru, což může pomoci vyhnout se vysokému zatížení webu a urychlit proces stahování, takže roli tohoto ochranného prostředku nelze podceňovat.
To znamená, že vzhledem k tomu, že je v současné době technicky nemožné stanovit nepřekonatelné bariéry pro všechny typy scrapingu, programy často nacházejí způsoby, jak taková ochranná opatření obejít. Tento faktor také naznačuje, že scraping je nelegální.
2. Scraping a uživatelské smlouvy (obchodní podmínky)
Takže jsme se zabývali otázkou, kdy je použití databází porušením. Představme si ale, že vlastník webu nemá související právo. Znamená to, že scraping nechráněných databází je a priori legální? Na tuto otázku by se mělo odpovědět záporně, protože legalita scrapingu závisí na dalších faktorech.
Pojďme se podívat na světovou soudní praxi.
Příkladem je případ Ryanair Ltd. v. PR Aviation BV. Evropský soudní dvůr rozhodl, že scraping je nezákonný, a uvedl, že majitelé webových stránek mají právo stanovit omezení používání svých webových stránek v uživatelských smlouvách, jejichž nedodržení je porušením, i když webové stránky nejsou uznávány jako databáze6. Bylo proto konstatováno, že uživatelské smlouvy mají velkou váhu a měly by být brány v úvahu i v případě neexistence souvisejících práv.
Tento závěr soudu dává důvod se domnívat, že uživatelské smlouvy jsou závazné ve všech případech a jejich nedodržování zbavuje scraping zákonnosti. Toto rozhodnutí se však jeví jako nejednoznačné a názory soudců na tuto otázku se liší.
V případu LinkedIn v. Robocog Inc.7 soud shledal jednání žalovaného porušením, když se zaregistroval pomocí falešných účtů na sociální síti za účelem získání přístupu k určitým informacím na webových stránkách žalobce, přičemž zejména uvedl skutečnost, že při registraci souhlasil s uživatelskými smlouvami. Odlišné posouzení uživatelské smlouvy je obsaženo v případu QVQ Inc. v. Resulty LLC8, kde soud poznamenal, že jelikož v samotné aplikaci Resultly, která analyzovala webové stránky žalobce, nelze nic zakoupit, a ta pouze odkazuje uživatele do obchodu, nedochází k porušení i přes zákaz takového shromažďování informací v pravidlech webových stránek žalobce.
Soudy tedy posuzují význam uživatelských smluv odlišně. Analýza těchto rozhodnutí nám nicméně umožňuje dojít k závěru, že nedodržování uživatelských smluv je důvodem k uznání scrapingu za nezákonný, pokud jej provádí konkurent webu, což má za následek „odliv“ uživatelů od žalobce k žalovanému. Takové jednání je považováno za nekalou soutěž. Pokud žalovaný nekonkuruje žalobci a zveřejní zabavené informace s odkazem na zdroj, nedodržování pravidel nebude porušením. V tomto případě scraping nejenže není škodlivý, ale také užitečný pro majitele webu (pokud například v důsledku tohoto jednání získal další návštěvníky, kteří přišli prostřednictvím odkazů z agregátoru zpráv). P.O. Stejného názoru je i Semin: „Pokud se činnosti subjektů doplňují, pak má smysl uznat scraping za legální, i když je formálně zakázán. Pokud například společnost shromažďuje informace o produktech z webových stránek několika internetových obchodů, ale sama tyto produkty neprodává, ale přesměrovává uživatele na webové stránky internetového obchodu, pak jedná jak ve svůj vlastní prospěch, tak ve prospěch internetového obchodu, takže striktně formální přístup k řešení sporu zde není zcela opodstatněný.“
Tento závěr se zdá být oprávněný, ale pouze pokud scraping nenarušuje provoz webu, protože zvyšuje jeho zátěž a snižuje jeho rychlost. Automatický sběr informací tedy kromě „lákání“ uživatelů může vést k významným ztrátám v důsledku selhání provozu webu. Například v roce 1999 podal Ebay žalobu na Bidder’s Edge 9, protože žalovaný scrapingoval rychlostí až 100 tisíc požadavků denně, což představovalo 1,53 % z celkového počtu požadavků na web. Soud přijal opatření k zajištění nároku s odvoláním na skutečnost, že takové jednání vedlo k dodatečným nákladům pro majitele webu; samotný případ skončil dohodou o narovnání.
Stručně řečeno, můžeme konstatovat, že nedodržování uživatelských smluv není důvodem k uznání scrapingu za nezákonný, pokud nedochází k nekalé soutěži a/nebo ztrátám způsobeným selháním v provozu webu. Jiný přístup může vést zejména k omezení hospodářské soutěže na trhu. Federální antimonopolní služba (FAS) ve svém rozhodnutí ve věci mezi OOO Stafori (PO Robot Vera) (žadatel) a OOO Headhunter 10 uvedla, že jednání druhé společnosti s cílem zablokovat žadatele vedlo k vytvoření překážek přístupu na komoditní trh pro tyto služby, tj. k omezení hospodářské soutěže na komoditním trhu. Navzdory skutečnosti, že uživatelská smlouva společnosti OOO Headhunter obsahovala zákaz automatizovaného shromažďování informací, bylo jednání druhé společnosti uznáno za porušení antimonopolních zákonů.
3. Scraping a osobní údaje
Scraping může shromažďovat informace týkající se konkrétních osob. Otázkou je, zda jsou shromážděné údaje osobní a zda je jejich zpracování zákonné.
Pokud jde o domácí praxi v této otázce, je třeba zmínit známý spor mezi sociální sítí VKontakte a společností OOO Double o ochranu souvisejících práv žalobce jakožto výrobce databází uživatelů sítě VKontakte 11. Program žalovaného shromažďoval veřejně dostupné osobní údaje uživatelů sociálních sítí za účelem posouzení jejich úvěruschopnosti v zájmu bank. Původně byla žaloba žalobce zamítnuta, odvolací soud toto rozhodnutí zrušil a SIP jej vrátil k novému projednání soudu prvního stupně. V námitce žalovaný poukázal zejména na skutečnost, že vlastníci sociálních sítí nemohou získat monopol na data uživatelů stránek a tyto informace jsou veřejně dostupné.
Otázkou je, zda jsou stránky sociálních sítí veřejně dostupnými zdroji informací o osobních údajích a zda je jejich shromažďování bez souhlasu subjektu přípustné. Je možné takové jednání odůvodnit odkazem na odstavec 10 článku 6 federálního zákona „O osobních údajích“12, podle kterého je možné zpracování osobních údajů zpřístupněných subjektem těchto údajů nebo s jeho souhlasem?
V roce 2015 Evropský soud v případu Maximillian Schrems v. Data Protection Commissioner13 považoval informace z veřejného profilu na sociální síti Facebook za osobní údaje. To znamená, že i informace o uživateli, které jsou veřejně dostupné, jsou často chráněny. Ruská soudní praxe a Roskomnadzor rovněž vycházejí ze skutečnosti, že stránky na sociálních sítích nejsou veřejně dostupnými zdroji osobních údajů. Například Rozhodčí soud v Moskvě uvedl, že „informace o subjektu (včetně osobních údajů) obsažené na sociálních sítích (na internetu) nelze klasifikovat jako osobní údaje zpřístupněné subjektem, jelikož sociální sítě nejsou zdrojem veřejně dostupných osobních údajů“14.
V USA můžeme v této otázce pozorovat opačný postoj. Tak v rozhodnutí v případu LinkedIn v. malé společnosti zabývající se analýzou dat hiQ Labs (tato společnost získávala data z veřejně dostupných uživatelských profilů LinkedIn a používala je k konzultacím se zaměstnavateli, jejichž zaměstnanci zveřejnili své životopisy na webu), soud uvedl, že zákaz shromažďování veřejně dostupných informací vytváří hrozbu pro jejich volnou výměnu, což je nekalá soutěž 15. Americký soud tak uznal, že osobní údaje zveřejněné na sociálních sítích jsou veřejně dostupné, a navíc sociální síti zakázal technicky bránit scrapingu. Je třeba poznamenat, že praxe vytváření technických ochranných prostředků není v Rusku zakázána, a to i v případě, že vlastník webu nemá související práva k databázi.
Podle našeho názoru je třeba při rozhodování o tom, zda scraping porušuje právní předpisy o osobních údajích, odkázat na odstavec 2 článku 5 federálního zákona „o osobních údajích“, podle kterého „zpracování osobních údajů neslučitelné s účely shromažďování osobních údajů není povoleno“. Jak správně poznamenal P.O. Semin, „při řešení tohoto problému by měl být kladen důraz . na důsledky zpracování osobních údajů“. I při uznání osobních údajů za veřejně dostupné informace by tedy měl být scraping uznán za nezákonný, pokud tyto jednání vedou k negativním důsledkům pro daného uživatele. Jinými slovy, při určování zákonnosti/nezákonnosti scrapingu je základní otázkou, zda jsou osobní údaje používány v souladu s účely jejich poskytování a zda scraping vede k negativním důsledkům pro danou osobu.
Scraping webových stránek je tedy legální, pokud neporušuje žádné zákonem stanovené zákazy. Lze proto identifikovat následující kritéria pro legalitu scrapingu.
- Nedochází k porušení autorských práv k materiálům webu a souvisejícím právům k databázi.
- Neexistuje žádné obejití technických ochranných opatření.
- Neexistuje žádná nekalá soutěž.
- V důsledku selhání webových stránek nedochází k žádným ztrátám.
- Osobní údaje jsou používány v souladu s účely, pro které jsou poskytnuty, a nemají pro jejich subjekt negativní důsledky.
Přítomnost všech těchto faktorů dohromady naznačuje legalitu scrapingu. Podle našeho názoru nám tato kritéria umožňují zajistit rovnováhu mezi výhradními právy k výsledkům duševní činnosti, investicemi tvůrců databází a potřebou chránit osobní údaje na jedné straně a právem na přístup k otevřeným informacím a rozvojem technologií na straně druhé.
1 Například s pomocí scrapingu maloobchodníci studují webové stránky konkurence, porovnávají ceny zboží a následně upravují ty své.
2 Upozorňujeme, že extrahované informace musí být veřejně dostupné, jinak je nezákonnost scrapingu zřejmá.
3 Občanský zákoník Ruské federace (část 4) ze dne 18. prosince 2006 N 230-FZ [Elektronický zdroj].
4 The British Horseracing Board Ltd a další proti William Hill Organization Ltd (rozsudek Soudního dvora EU C-203/02, 2004).
5 Takové použití je oprávněné pro účely, pro které mu je databáze poskytnuta, v jakémkoli objemu, pokud smlouva nestanoví jinak; pro osobní, vědecké, vzdělávací účely v objemu odůvodněném stanovenými účely a pro jiné účely v objemu tvořícím nevýznamnou část databáze.
6 Ryanair Ltd. proti PR Aviation BV (C-30/14, 2015).
7 LinkedIn v. Robocog Inc. (rozsudek soudu č. 14-00068 (N.D. Cal. 2014)).
8 QVC, Inc. proti Resultly, LLC (99 F. Supp. 3d 525 (2015).
9 EBay v. Bidder’s Edge, 100 F. Supp. 2d 1058 (N.D. Cal. 2000).
10. spisová značka 11/01/10-9/2019.
11 Дело № А40-18827/17-110-180 // https://kad.arbitr.ru/Card/1f33e071-4a16-4bf9-ab17-4df80f6c1556
12 Federální zákon ze dne 27. července 2006 N 152-FZ „O osobních údajích“ [Elektronický zdroj].
13 Maximillian Schrems proti Data Protection Commissioner (případ C-362/14).
14 Věc A40-5250/2017 // http://kad.arbitr.ru/
15 HIQ Labs, Inc. proti Linkedin Corp (273 F. Supp. 3d 1099 (N.D. Cal. 2017)).
Potřebovali jste někdy rychle a snadno shromáždit velké množství dat z webových stránek? A právě zde přichází na řadu webový scraping!
Web scraping je metoda používaná k automatickému shromažďování velkého množství informací z webových stránek během několika minut.
Místo trávení hodin ručním kopírováním a vkládáním dat udělají nástroje pro webový scraping veškerou práci za vás.
Společnosti po celém světě používají web scraping ke shromažďování důležitých dat pro průzkum trhu, porovnávání cen, analýzu zákaznických informací a dokonce i pro generování leadů. Pomáhá šetřit čas, zvyšovat efektivitu a činit chytřejší rozhodnutí.
Pojďme se jednoduše dozvědět, co je web scraping, jak funguje a jak může prospět vašemu podnikání. Pojďme se podívat, jak vám web scraping může pomoci s růstem vašeho podnikání!
Co je to webový scraping?
Web scraping není nový proces. Tato praxe existuje již mnoho let.
Jeho popularita však vzrostla až v posledních několika letech, což vedlo k vytvoření softwaru, který automatizuje proces sběru webových dat a zrychluje a zefektivňuje jej.
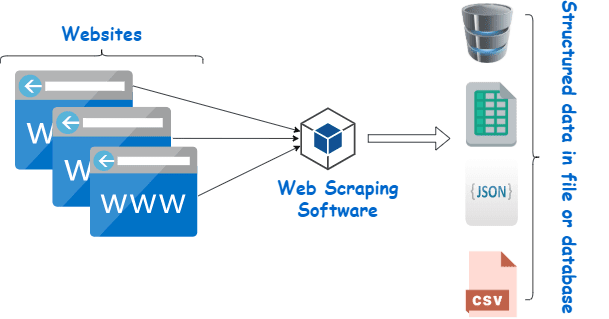
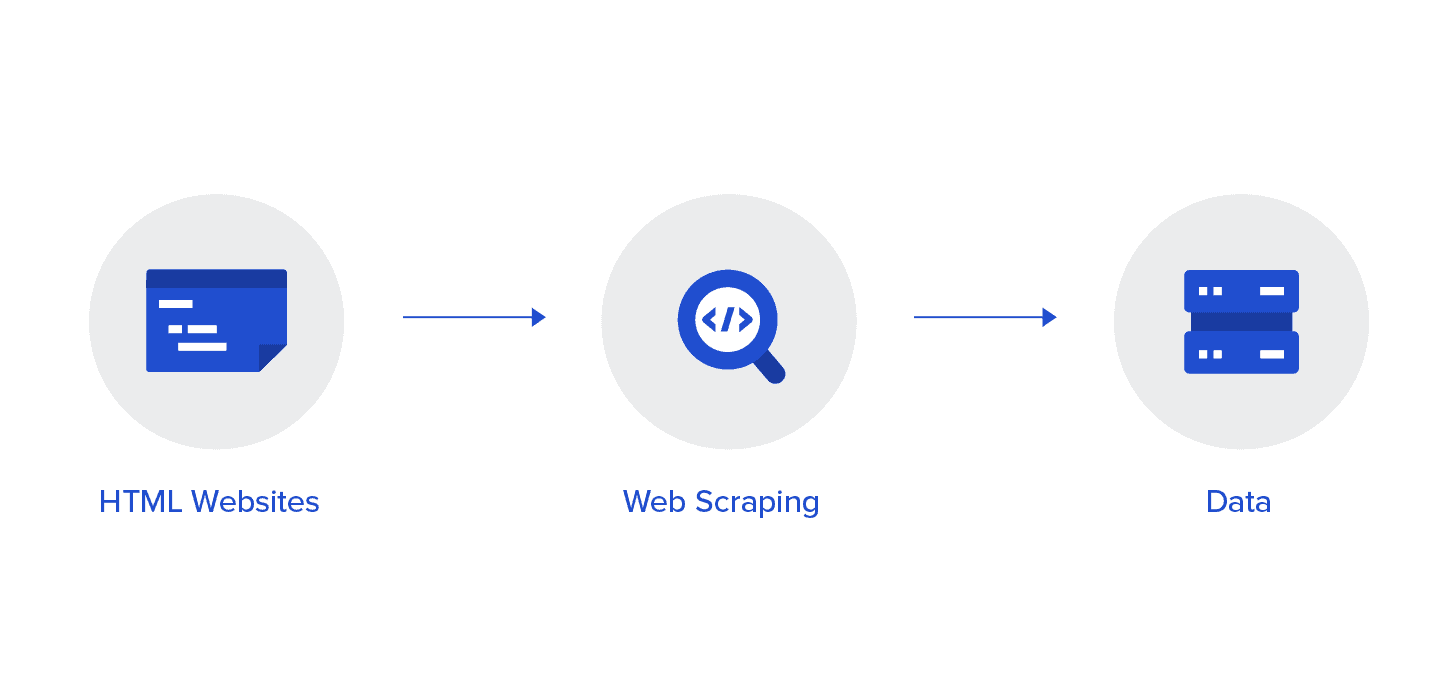
Web scraping je proces shromažďování určitých veřejně dostupných dat z více webových stránek a jejich sestavování do jednotného formátu, který lze vyhodnocovat nebo používat různými způsoby.
V podstatě nastavíte parametry ve svém nástroji pro sběr webových dat, abyste určili typ informací, které chcete shromažďovat, například ceny produktů.
Poté spustíte software a ten automaticky prohledá web, shromáždí požadovaná veřejná data a převede je do čitelné podoby.
Po analýze budou informace sestaveny do požadovaného formátu, například do tabulky.
Jak se používá webový scraping?
Web scraping lze využít k různým účelům. To, co můžete dělat s veřejnými daty, která shromažďujete, je omezeno pouze vaší fantazií.
Například někdo může pomocí webového scrapingu shromáždit ceny konkrétní položky, aby získal nejlepší nabídku. Alternativně může někdo použít webový scraping k zobrazení všech nemovitostí na prodej ve své oblasti, když hledá dům ke koupi.
Z webového scrapingu můžete získat i mnoho výhod, pokud jde o vaše podnikání. Webový scraping můžete využít na začátku k provedení marketingového průzkumu a analýzy nákladů pro váš podnikatelský plán.
Můžete také použít webový scraping k určení ceny podobných produktů prodávaných konkurencí, čímž zajistíte, že vaše ceny zůstanou konkurenceschopné.
Dolování webových dat lze také využít ke shromažďování cenných statistik, díky nimž bude vaše nabídka pro klienta atraktivnější.
Neexistují žádná omezení, jak můžete web scraping využít pro své podnikání. Zde je několik dalších oblastí, kde může web scraping prospět vašemu podnikání.
- Vedoucí generace
- Porovnání a sledování cen
- Cenové informace
- Obohacování technologie strojového učení
- Agregace finančních dat
- Monitorování spotřebitelské nálady
- Sledování zpráv
- Analýza dat
- Akademický výzkum
Co je etický webový scraping?
Je důležité shromažďovat data etickým způsobem. Bohužel někteří lidé tento nástroj zneužívají.
Někteří lidé se snaží ukrást informace, které by shromažďovat neměli, například osobní údaje nebo obsah skrytý za bezpečnostními opatřeními, jako jsou přihlašovací údaje a další.
Existují také scrapery, které odesílají více požadavků na scraping na stejnou webovou stránku, což web zpomaluje a může vést k jeho pádům.
Abychom mohli využít výhod, které tento nástroj nabízí, musíme zajistit jeho etické používání. Součástí toho je zajištění toho, abyste extrahovali pouze veřejně dostupná data a nikdy se nepokoušeli shromažďovat osobní údaje nebo obsah chráněný přihlašovacími údaji, hesly nebo jinými opatřeními.
Je také důležité nepřetěžovat web, ze kterého scrapingujete, příliš velkým počtem požadavků. Místo toho požadavky rozložte nebo naplánujte scraping na dobu, kdy je návštěvnost webu pomalá.
A konečně, ujistěte se, že s veškerými shromážděnými údaji zacházíte s respektem a nikdy nevydáváte cizí údaje za svá vlastní.
Jaké typy webových scraperů existují?
Existují různé typy webových scraperů, každý z nich je určen pro specifické úkoly. Zde jsou nejběžnější typy:
1. Ruční škrabky
Manuální webové scrapery jsou jednoduché nástroje, které uživatelům umožňují ručně vybírat a extrahovat data z webové stránky. Tento typ se často používá pro malé úkoly, ale je časově náročný a neefektivní pro rozsáhlé scrapingy.
2. Jednoduché škrabky
Jedná se o automatizované nástroje, které dokáží extrahovat data ze základních webových stránek. Jsou navrženy tak, aby shromažďovaly data ze statických webových stránek, kde se obsah nemění nebo se načítá dynamicky.
Jednoduché scrapery lze použít pro úkoly, jako je sběr textu, odkazů a obrázků.
3. Vylepšené škrabky
Pokročilé scrapery jsou výkonnější a zvládají dynamický obsah, jako jsou webové stránky, které k načítání dat používají JavaScript.
Mohou napodobovat lidské akce (klikání, rolování) pro interakci se stránkou a extrahování informací ze složitých webových stránek, jako jsou platformy sociálních médií nebo e-commerce stránky.
4. Prohlížeče bez rozhraní
Headless prohlížeče jsou webové prohlížeče, které fungují bez grafického rozhraní. Jsou skvělé pro scraping webových stránek s velkým množstvím JavaScriptu nebo webových stránek, které vyžadují interakci (jako je přihlašování nebo vyplňování formulářů).
Nástroje jako Puppeteer nebo Selenium používají prohlížeče bez headsetu k simulaci lidského chování při prohlížení webu.
5. API scrapery
Některé webové stránky poskytují API (rozhraní pro programování aplikací) pro přístup k datům ve strukturovaném formátu. API scrapery se k těmto API připojují a extrahují data přímo z nich.
Tato metoda je efektivnější a méně náchylná k blokování než tradiční parsování.
6. Distribuované škrabky
Distribuovaný sběr dat označuje použití více serverů nebo IP adres k současnému sběru dat z webových stránek.
Tento typ scraperu je užitečný, když potřebujete rychle shromáždit velké množství dat nebo když webové stránky blokují IP adresy, které odesílají příliš mnoho požadavků.
Každý typ parseru je vhodný pro různé úkoly v závislosti na složitosti webové stránky a množství požadovaných dat.
Pochopení toho, který nástroj zvolit pro konkrétní úkol, pomůže zajistit, aby scraping probíhal efektivně a bez porušení pravidel webu.
Jak fungují webové scrapery?
Webové scrapery jsou nástroje nebo software používané k automatickému sběru dat z webových stránek. Obvykle fungují takto:
- Odeslat požadavkyScraper odešle HTTP požadavek na server webové stránky pro přístup k jejímu obsahu, podobně jako prohlížeč načítá stránku.
- Načíst HTML obsahPo odpovědi serveru stáhne scraper HTML kód webové stránky, který obsahuje veškerý obsah, jako je text, obrázky a odkazy.
- Analyzovat HTMLScraper analyzuje HTML kód pomocí specifické metody parsování (například BeautifulSoup nebo lxml pro Python) za účelem extrahování relevantních dat (jako jsou ceny produktů, uživatelské recenze atd.).
- Extrakce datScraper identifikuje požadované datové body na základě HTML tagů, CSS tříd nebo XPath a extrahuje tyto informace.
- Ukládání datExtrahovaná data se poté ukládají ve strukturovaném formátu, jako je soubor CSV, databáze nebo JSON, pro snadnou analýzu a použití.
- Ovládání navigaceNěkteré webové scrapery dokáží zpracovat stránkování nebo dynamický obsah (například obsah načtený pomocí JavaScriptu) simulací kliknutí nebo prováděním dalších požadavků na sběr dat z více stránek.
Web scraping se široce používá pro průzkum trhu, porovnávání cen, dolování dat a SEO analýzu, což umožňuje firmám i jednotlivcům rychle shromažďovat velké množství informací.
Mám při scrapingu webových stránek používat proxy?
Ano, při sběru dat byste měli používat rezidenční proxy server.
I když je možné použít proxy z datového centra, rezidenční proxy je mnohem spolehlivější, pokud jde o web scraping. Je to proto, že rezidenční proxy jsou spojeny se skutečnými zařízeními s IP adresami a poskytovatelem internetových služeb.
Tímto způsobem budou veškeré požadavky z tohoto proxy serveru vypadat jako od skutečného návštěvníka webu a nebudou blokovány, takže můžete shromažďovat více dat a ujistit se, že shromážděná data jsou přesná.
Rychlé odkazy
- Nejlepší proxy pro eBay
- Nejlepší proxy pro Scrapebox
- Nejlepší proxy servery Tripadvisoru
- Nejlepší proxy pro Twitter
- Nejlepší sdílené proxy
- Nejlepší proxy pro Kanadu
Závěrečné myšlenky: Co je webový scraping v roce 2025?
Web scraping je mocný nástroj, který pomáhá firmám rychle a efektivně shromažďovat cenná data.
Ať už potřebujete informace o konkurenci, sledování cen, tržní trendy nebo data o zákaznících, web scraping celý proces usnadňuje.
Místo trávení hodin ručním shromažďováním informací automatizace zvládne práci během několika minut. To znamená činit lepší rozhodnutí, implementovat chytřejší strategie a dosahovat rychlejšího růstu firmy.
Se správnými nástroji a technikami vám web scraping může poskytnout velkou výhodu v dnešním světě založeném na datech. Začněte web scraping používat ještě dnes, abyste získali konkurenční výhodu a otevřeli nové příležitosti pro své podnikání!
Kašiš Bubber
Tento autor je ověřen na BloggersIdeas.com
Kashish je absolventkou bakalářského studia obchodu a v současné době se věnuje své vášni pro učení se a psaní o SEO a blogování. S každou novou aktualizací algoritmů Googlu se ponořuje do detailů. Vždy se chce učit a ráda zkoumá každý zápletku aktualizací algoritmů Googlu, ponořuje se do složitostí, aby pochopila, jak fungují. Její nadšení pro tato témata je patrné v jejích textech, díky čemuž jsou její myšlenky informativní i fascinující pro každého, kdo se zajímá o neustále se vyvíjející oblast SEO a umění blogování.
Zveřejnění affiliate partnera: Úplná transparentnost – některé odkazy na našich webových stránkách jsou přidružené, a pokud je použijete k nákupu, obdržíme provizi bez dalších nákladů pro vás (vůbec žádné další náklady!).
Zanechat komentář Zrušit odpověď
Kontaktujte nás
Přihlásit se
O mně
Jitendra Vaswani vyniká jako transformativní lídr v oblasti SEO a affiliate marketingu, známý pro své výjimečné odborné znalosti a inovativní změny, které do odvětví přináší.
na webu
Jak je znázorněno na
Nápady blogerů® — registrovaná ochranná známka. Veškerý obsah je chráněn autorským právem, přetisk je zakázán.
Veškerý obsah a informace na těchto webových stránkách a/nebo v newsletteru, včetně našich programů, produktů a/nebo služeb, slouží pouze pro informační a vzdělávací účely, nepředstavují odborné poradenství jakéhokoli druhu a používáním těchto webových stránek a/nebo newsletteru s vámi nevytváří žádný profesionálně-klientský vztah. Profesionálně-klientský vztah s vámi vzniká až poté, co s vámi výslovně uzavřeme písemnou smlouvu, kterou jste podepsali, včetně naší struktury poplatků a dalších podmínek spolupráce s vámi na konkrétní záležitosti. I když se snažíme poskytovat přesné obecné informace, zde uvedené informace nenahrazují žádné odborné poradenství a neměli byste se spoléhat pouze na tyto informace. Před učiněním jakýchkoli profesních, právních, finančních nebo daňových rozhodnutí se vždy poraďte s odborníkem v oboru ohledně vašich konkrétních potřeb a okolností.
© 2025 BloggersIdeas | Všechna práva vyhrazena | Partnerské stránky a partnerský programDivize Booster DigiExe
- Zásady ochrany osobních údajů
- Условия использования